L’Europe peut-elle dépendre des IA américaines pour transformer ses entreprises ?

Les entreprises européennes adoptent rapidement l’intelligence artificielle. Elles automatisent une partie de leur service client, accélèrent la production de contenus, analysent leurs données, assistent leurs commerciaux, développent des logiciels et commencent à confier certaines tâches à des agents capables d’agir de manière de plus en plus autonome.

Mais derrière cette transformation se cache une réalité moins souvent évoquée : une grande partie des technologies qui la rendent possible n’est pas européenne.

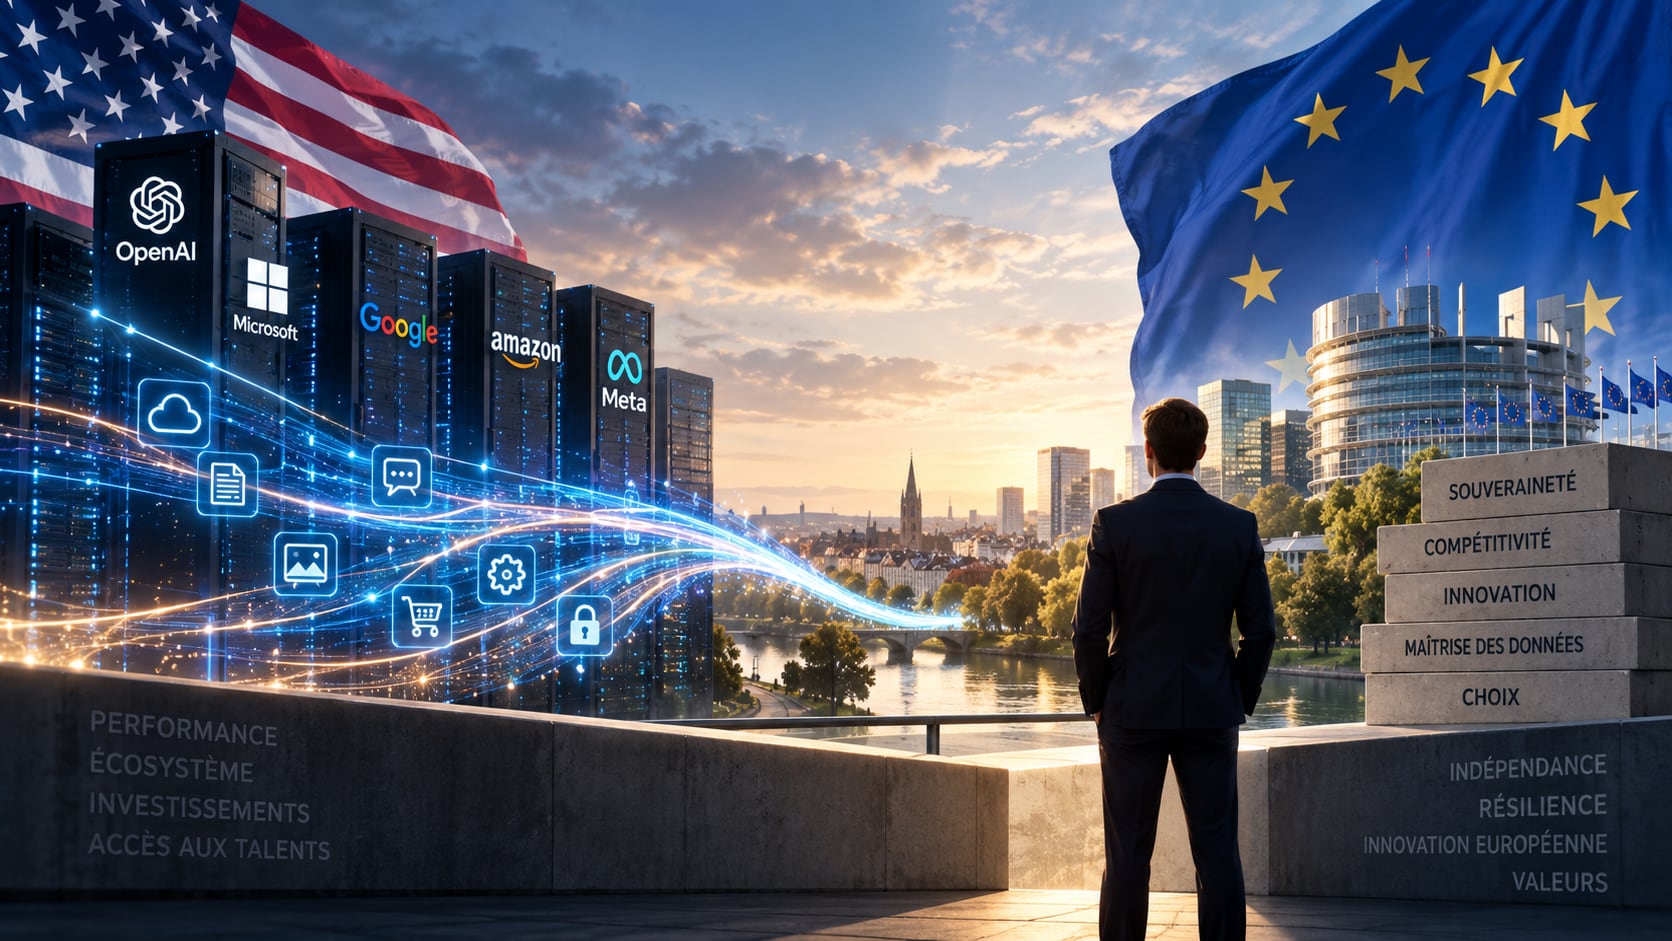
OpenAI, Microsoft, Google, Anthropic, Amazon ou Meta occupent une place considérable dans l’écosystème actuel de l’intelligence artificielle et du cloud. Cela ne constitue pas, en soi, un problème. Les entreprises européennes ont tout intérêt à utiliser les technologies les plus performantes lorsqu’elles leur permettent d’innover, de gagner du temps ou d’améliorer leur compétitivité.

La véritable question est ailleurs : que se passe-t-il lorsque l’utilisation d’une technologie devient une dépendance ?

Cette interrogation a pris une dimension particulière le 14 septembre 2026. Dans un discours prononcé à Vienne, Christine Lagarde, présidente de la Banque centrale européenne, a estimé que l’Europe devait devenir davantage productrice des technologies d’intelligence artificielle dont elle aura besoin.

Son propos mérite d’être regardé au-delà du débat sur la souveraineté numérique. Car derrière la dépendance technologique européenne apparaît progressivement une question très concrète pour les entreprises : conserveront-elles demain la maîtrise des technologies sur lesquelles elles auront construit leur organisation ?

L’Europe adopte l’intelligence artificielle plus vite qu’elle ne la produit

La situation européenne comporte un paradoxe.

Jamais les entreprises du continent n’ont adopté aussi rapidement certaines technologies numériques avancées. Selon le rapport State of the Digital Decade 2026 de la Commission européenne, près de 20 % des entreprises de l’Union utilisent désormais l’intelligence artificielle, après une progression de 48 % de son adoption au cours de l’année 2025.

Dans le même temps, 46,7 % des entreprises européennes utilisent des services cloud.

L’Europe est donc bien engagée dans sa transformation numérique, mais elle s’appuie largement sur des technologies développées ailleurs.

Dans son discours du 14 septembre, Christine Lagarde a rappelé quelques chiffres particulièrement révélateurs. Au cours de l’année précédente, les États-Unis ont produit 59 modèles d’intelligence artificielle considérés comme remarquables et la Chine 35. La France et le Royaume-Uni n’en ont produit qu’un chacun.

L’écart est encore plus spectaculaire lorsque l’on observe les infrastructures nécessaires pour entraîner et faire fonctionner ces modèles : les États-Unis concentreraient environ 75 % de la capacité mondiale de calcul consacrée à l’IA, contre seulement 5 % pour l’Europe.

Le problème européen n’est donc pas l’absence d’utilisation de l’intelligence artificielle. Il réside davantage dans le décalage entre sa capacité à utiliser la technologie et sa capacité à la produire, l’héberger et la maîtriser.

Dépendre d’une technologie étrangère est-il forcément un problème ?

Non.

Une entreprise française qui utilise Microsoft 365, Google Workspace, Salesforce, AWS, ChatGPT ou Claude ne perd pas automatiquement son autonomie.

Les entreprises ont toujours acheté des technologies qu’elles ne produisaient pas elles-mêmes. Une PME industrielle n’a aucune raison de fabriquer ses propres serveurs, de développer son propre système d’exploitation ou de créer un modèle de langage pour bénéficier de l’intelligence artificielle.

Vouloir atteindre une autonomie technologique absolue serait probablement aussi coûteux qu’inefficace.

La question devient différente lorsque la technologie concernée n’est plus seulement un outil parmi d’autres, mais une infrastructure dont dépend progressivement le fonctionnement de l’entreprise.

Imaginons qu’une société construise son service client autour d’un modèle d’IA particulier. Ses collaborateurs apprennent à travailler avec lui. Ses données sont organisées pour être exploitées par cette technologie. Ses applications utilisent ses API. Ses procédures internes sont progressivement adaptées à son fonctionnement.

Changer de fournisseur n’équivaut alors plus à changer de logiciel.

Il faut reconstruire les interfaces, adapter les processus, parfois déplacer les données, former les collaborateurs et accepter une période d’incertitude.

La dépendance commence réellement lorsque le coût ou la difficulté de sortie deviennent suffisamment élevés pour empêcher l’entreprise de choisir librement.

C’est ce que l’on appelle traditionnellement le vendor lock-in, ou enfermement propriétaire. Avec l’intelligence artificielle, cette question prend une nouvelle dimension.

Pourquoi l’intelligence artificielle change-t-elle la nature de cette dépendance ?

Un logiciel traditionnel exécute généralement une fonction relativement délimitée.

L’intelligence artificielle tend au contraire à s’introduire progressivement dans une multitude de processus.

Aujourd’hui, elle rédige, synthétise, analyse ou conseille. Demain, les agents IA pourront plus fréquemment déclencher des opérations, interroger plusieurs logiciels, envoyer des messages, modifier des données ou prendre en charge une partie d’un processus de travail.

Christine Lagarde donne une illustration beaucoup plus large de cette évolution. Selon elle, l’IA pourrait prochainement intervenir dans le contrôle des marchandises aux frontières, la sélection des déclarations fiscales à contrôler, la gestion des trains, la surveillance des patients hospitalisés ou encore le traitement des paiements bancaires.

À mesure que cette technologie s’insère dans l’économie, la dépendance ne porte donc plus seulement sur un logiciel. Elle peut concerner une partie du fonctionnement même des organisations.

C’est ici que le raisonnement change.

Si un fournisseur modifie ses tarifs, ses conditions d’utilisation, les capacités de ses modèles, ses règles d’accès ou ses politiques concernant les données, l’entreprise cliente doit s’adapter.

Et si plusieurs fonctions de l’entreprise reposent sur le même écosystème technologique, le rapport de force devient particulièrement déséquilibré.

Le risque est aussi économique

Cette dépendance possède une autre dimension, moins visible.

Lorsqu’une entreprise européenne achète des services d’intelligence artificielle américains, une partie de la valeur créée par sa transformation numérique rémunère les entreprises qui fournissent les modèles, le cloud et les infrastructures nécessaires à leur fonctionnement.

Cela ne signifie évidemment pas que l’entreprise européenne ne bénéficie pas elle-même de gains de productivité. Mais une partie de la valeur générée remonte vers les fournisseurs de la technologie.

Christine Lagarde souligne d’ailleurs un paradoxe : les Européens participent indirectement au financement de l’industrie technologique américaine. Selon les chiffres cités dans son intervention, les ménages de la zone euro détiennent environ 440 milliards d’euros d’actions d’entreprises technologiques américaines.

L’Europe finance donc en partie les infrastructures et entreprises technologiques dont elle devient ensuite cliente.

Le phénomène n’est pas nouveau. Mais l’importance économique que pourrait prendre l’intelligence artificielle lui donne une autre portée.

Faut-il alors privilégier systématiquement une IA européenne ?

Ce serait une conclusion trop rapide.

La nationalité d’un fournisseur ne suffit pas à déterminer la qualité d’une solution, sa sécurité ou sa pertinence économique.

Une entreprise ne devrait pas choisir un modèle moins performant uniquement parce qu’il est européen, pas davantage qu’elle ne devrait sélectionner automatiquement une technologie américaine parce qu’elle domine actuellement le marché.

La bonne question est plutôt : quel niveau de dépendance sommes-nous prêts à accepter pour cet usage précis ?

Pour produire des idées de publications sur les réseaux sociaux, la dépendance à un fournisseur particulier peut être relativement peu préoccupante. Si le service disparaît demain, il sera généralement possible d’en adopter un autre.

Pour une application qui traite des informations stratégiques, pilote une activité industrielle, intervient dans une décision financière ou devient indispensable au service client, la réponse est différente.

Plus l’usage devient sensible, plus la capacité à changer de technologie devrait entrer dans la décision initiale.

C’est probablement ainsi qu’il faut comprendre la notion de souveraineté numérique à l’échelle d’une entreprise.

Elle ne consiste pas nécessairement à tout acheter en Europe.

Elle consiste à rester capable de choisir.

L’Europe commence à réagir

Les institutions européennes ont manifestement identifié le problème.

Le rapport Digital Decade 2026 reconnaît explicitement que les dépendances envers des fournisseurs non européens demeurent significatives dans le cloud, la cybersécurité et plusieurs technologies stratégiques.

La Commission européenne a donc présenté, en juin 2026, un ensemble de mesures consacré à la souveraineté technologique européenne, couvrant notamment les semi-conducteurs, l’intelligence artificielle, le cloud et l’open source.

L’un des objectifs affichés du futur règlement sur le développement du cloud et de l’IA est particulièrement ambitieux : au moins tripler la capacité des centres de données de l’Union européenne au cours des cinq à sept prochaines années.

Le texte envisage également différents niveaux de souveraineté pour les services cloud et IA, allant de l’hébergement des données sur des infrastructures situées dans l’Union jusqu’à des exigences beaucoup plus fortes concernant le contrôle du fournisseur, sa chaîne logicielle et son indépendance vis-à-vis des pays tiers.

La question n’est donc plus seulement théorique.

Elle commence à se traduire dans les politiques industrielles et réglementaires européennes.

Mais construire des centres de données ne suffira pas

Il serait cependant trompeur de réduire le retard européen à un manque d’infrastructures.

Un centre de données n’est qu’une partie de l’écosystème nécessaire à l’intelligence artificielle.

Il faut également des semi-conducteurs, de l’énergie, des capitaux, des chercheurs, des ingénieurs, des données de qualité, des entreprises capables de transformer la recherche en produits et surtout un marché suffisamment vaste pour permettre à ces entreprises de changer d’échelle.

Le rapport européen Digital Decade 2026 montre bien cette difficulté. L’Union européenne ne représente encore qu’environ 9 % du marché mondial des semi-conducteurs, alors que l’objectif fixé pour 2030 est de 20 %.

La souveraineté technologique ne se décrète donc pas.

Elle se construit dans la durée.

Les entreprises n’ont pas besoin d’attendre l’Europe pour agir

Pour un dirigeant, la question pourrait sembler lointaine. Elle ne l’est pas.

Lorsqu’une entreprise choisit aujourd’hui une architecture d’intelligence artificielle, elle prend parfois une décision qui structurera son système d’information pendant plusieurs années.

Avant de déployer massivement une solution, quelques questions méritent donc d’être posées.

  • Nos données peuvent-elles être récupérées facilement ?
  • Nos processus peuvent-ils fonctionner avec un autre modèle d’intelligence artificielle ?
  • Nos applications dépendent-elles d’API propriétaires difficiles à remplacer ?
  • Que se passerait-il si le prix du service doublait ?
  • Combien de temps faudrait-il pour migrer vers une solution concurrente ?
  • Avons-nous conservé en interne suffisamment de compétences pour organiser cette migration ?

Ces questions ne concernent pas uniquement les grands groupes.

Une PME qui automatise progressivement son marketing, son service client ou sa production documentaire autour d’un même fournisseur peut elle aussi créer une dépendance sans véritablement s’en rendre compte.

Le danger n’est pas nécessairement d’utiliser une technologie américaine.

Le danger consiste à découvrir trop tard que l’on ne peut plus facilement s’en passer.

Vers une souveraineté numérique plus pragmatique

Le débat européen gagnerait probablement à sortir de l’alternative entre deux positions caricaturales. D’un côté, imaginer que l’Europe pourrait rapidement remplacer l’ensemble des technologies américaines n’est guère réaliste. De l’autre, considérer que la nationalité des infrastructures et des fournisseurs n’a aucune conséquence stratégique serait tout aussi naïf. L’enjeu consiste davantage à identifier les technologies pour lesquelles une dépendance est acceptable et celles pour lesquelles elle devient risquée.

Une entreprise peut parfaitement utiliser les meilleurs modèles américains tout en conservant ses données dans un environnement maîtrisé, en évitant de construire des applications impossibles à migrer et en maintenant plusieurs options technologiques. Elle peut également combiner modèles propriétaires et modèles ouverts, fournisseurs internationaux et européens, cloud public et infrastructures plus contrôlées.

Cette approche est moins spectaculaire qu’un appel à l’indépendance numérique totale. Elle est probablement beaucoup plus réaliste.

Ce qu’il faut en retenir

L’Europe peut utiliser les intelligences artificielles américaines pour accélérer la transformation de ses entreprises. Elle aurait en revanche intérêt à ne pas construire cette transformation de manière à en devenir irréversiblement dépendante.

La nuance est fondamentale.

La souveraineté numérique d’une entreprise ne se mesure pas au nombre de fournisseurs européens présents dans son système d’information. Elle se mesure davantage à sa capacité à conserver ses données, comprendre ses dépendances, changer de fournisseur et continuer à fonctionner lorsqu’un partenaire technologique modifie ses conditions.

L’intelligence artificielle américaine constitue aujourd’hui une formidable source d’innovation pour les entreprises européennes. Refuser de l’utiliser au nom d’une autonomie absolue pourrait leur faire perdre une partie des gains de productivité qu’elle promet.

Mais construire l’entreprise de demain sur des technologies dont elle ne pourrait plus se séparer créerait une vulnérabilité d’une autre nature.

Entre le refus et la dépendance, il existe donc une troisième voie : utiliser les meilleures technologies disponibles, tout en conservant la liberté d’en changer.

C’est peut-être là que commence, pour une entreprise, la véritable souveraineté numérique.

#IntelligenceArtificielle
#SouverainetéNumérique
#TransformationNumérique
#Europe
Par |16 septembre 2026|Catégories : ETI, GE, IA, PME, TPE|Mots-clés : , , |0 commentaire

Votre cerveau sous ChatGPT

Avec l’essor fulgurant des intelligences artificielles génératives, l’éducation entre dans une nouvelle ère. Mais que sacrifie-t-on en confiant à la machine une partie de notre pensée ? Une étude scientifique du MIT lève le voile sur les effets méconnus de l’usage de ChatGPT sur notre cerveau.

Une facilité cognitive à double tranchant

Les grands modèles de langage comme ChatGPT ont fait irruption dans nos vies en promettant un accès simplifié au savoir, des réponses claires, rapides, et adaptées. Mais en déchargeant notre cerveau d’une partie de l’effort de recherche, de réflexion et de formulation, ne risquons-nous pas d’en payer le prix cognitif ?

C’est la question que pose l’étude conduite par le MIT Media Lab et plusieurs partenaires universitaires. Elle propose un protocole expérimental inédit pour mesurer, via l’EEG et des analyses croisées, l’impact de l’utilisation d’une IA lors d’une tâche d’apprentissage complexe : la rédaction d’un essai argumenté.

L’enjeu est simple : comprendre si, comment et à quel prix l’IA modifie l’engagement cognitif, la mémoire, le sentiment de propriété intellectuelle, et la qualité de l’apprentissage.

Le protocole – Trois groupes, un objectif

Pour explorer les effets cognitifs de l’utilisation de l’intelligence artificielle dans une tâche d’apprentissage complexe, les chercheurs ont mis en place une méthodologie expérimentale rigoureuse reposant sur la répartition de 54 étudiants en trois groupes distincts, constitués de manière aléatoire, mais équilibrée en termes de genre et d’âge :

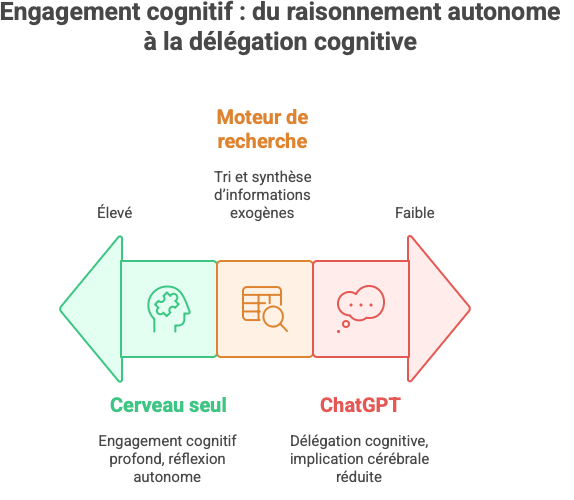
  • Groupe LLM (Large Language Model) : les participants de ce groupe devaient rédiger leurs essais exclusivement à l’aide de ChatGPT, sans recourir à aucun autre support ni source d’information.
  • Groupe moteur de recherche : les étudiants avaient accès à Internet via un moteur de recherche (principalement Google), mais toute interaction avec un agent conversationnel de type LLM était interdite.
  • Groupe cerveau seul : dans ce cas, les étudiants devaient s’appuyer uniquement sur leurs propres connaissances, sans outil numérique, ni moteur de recherche, ni IA.

Chaque étudiant participait à trois sessions d’écriture, à raison d’un essai par session, sur des sujets inspirés des épreuves du SAT américain. Les essais étaient produits en temps limité (20 minutes), dans des conditions encadrées. Lors de chaque session, plusieurs types de données étaient collectés :

  • des signaux d’activité cérébrale par électroencéphalographie (EEG),
  • les productions écrites elles-mêmes, évaluées par des enseignants et une IA d’analyse linguistique,
  • et des entretiens qualitatifs réalisés en fin de séance, permettant de recueillir les impressions, les stratégies cognitives et le ressenti des participants.

Enfin, une quatrième session était proposée à un sous-groupe volontaire : ceux ayant travaillé avec ChatGPT devaient rédiger un essai sans aide, et inversement. Cette inversion permettait d’observer les effets de l’usage antérieur de l’IA sur les capacités ultérieures de rédaction autonome.

En combinant ainsi données neurophysiologiques, performances linguistiques et témoignages subjectifs, ce protocole avait pour ambition de produire une analyse multi-niveaux, offrant une compréhension fine des mécanismes cognitifs à l’œuvre selon les modalités d’accompagnement technologique mobilisées.

Les résultats EEG – Quand l’effort mental diminue, la dette cognitive augmente

Les analyses de connectivité neuronale réalisées à partir des enregistrements EEG révèlent des différences nettes et systématiques entre les trois groupes étudiés. En cartographiant l’activité cérébrale pendant l’acte d’écriture, les chercheurs ont pu observer l’intensité et la répartition des réseaux activés dans les différentes bandes de fréquences (alpha, beta, delta, theta), indicateurs classiques de l’attention, de la mémoire de travail, de l’intégration sensorielle et de la planification cognitive.

  • Votre cerveau sous ChatGPT
    Le groupe cerveau seul présente la plus grande amplitude et la plus forte connectivité neuronale. Les réseaux frontaux, impliqués dans la planification et le raisonnement, les régions pariétales (traitement spatial et attentionnel), ainsi que les zones occipitales (visualisation mentale) sont activés de manière coordonnée. Cela traduit un engagement cognitif profond et une sollicitation importante des capacités de réflexion autonome.
  • Le groupe moteur de recherche affiche une activation intermédiaire, localisée notamment dans les régions associées à la gestion de la charge visuelle et au traitement de l’information exogène. Cela suggère un effort de tri, d’évaluation et de synthèse d’informations disparates issues d’Internet, mais avec une implication cérébrale moins dense que celle observée sans aide.
  • Le groupe ChatGPT montre, quant à lui, une activité beaucoup plus modeste. La connectivité est faible, en particulier dans les bandes alpha et beta, qui correspondent respectivement à l’attention soutenue et à la mobilisation de la mémoire de travail. Cette sous-activation témoigne d’un phénomène de délégation cognitive : le cerveau « sous-traite » certaines fonctions, réduisant l’intensité de son implication.

Un constat inquiétant ressort de la session 4 du protocole : les participants initialement habitués à l’usage de ChatGPT, lorsqu’ils doivent rédiger sans aide, conservent une activation cérébrale atone. Le cerveau semble s’être « reconfiguré » pour un fonctionnement assisté, et peine à retrouver ses réflexes cognitifs en autonomie. C’est ce que les auteurs désignent comme une dette cognitive : une perte d’agilité mentale consécutive à un usage prolongé d’une IA, qui se traduit par une diminution de la capacité à activer les circuits cognitifs fondamentaux. Cette forme de paresse neuronale acquise, une fois installée, devient difficile à corriger sans un travail conscient de réactivation des fonctions mentales profondes.

L’analyse des textes – Moins de pensée, plus d’homogénéité

Les productions issues du groupe utilisant ChatGPT révèlent des caractéristiques linguistiques spécifiques qui les distinguent nettement des essais rédigés par les deux autres groupes. L’analyse lexicale montre une récurrence marquée de structures syntaxiques standardisées et l’usage fréquent de formules de transition génériques, signes d’un langage calibré mais peu inventif. Cette homogénéité se manifeste notamment par la répétition de certains N-grams (groupes de mots récurrents), utilisés de manière quasi automatique, et par un vocabulaire à la fois plus abstrait et moins ancré dans l’expérience personnelle.

Les juges humains qui ont évalué les textes ont souligné une absence de relief dans les arguments, une tendance à la paraphrase et un manque de nuances dans la construction des raisonnements. En d’autres termes, les textes paraissent formellement corrects, mais souffrent d’un déficit de singularité : peu d’ancrage contextuel, peu d’originalité, peu de prises de position affirmées.

Ce constat est corroboré par les analyses de l’IA d’évaluation, qui détecte une faible diversité lexicale et une densité argumentative moyenne, bien que la syntaxe soit fluide et la grammaire globalement irréprochable. En somme, l’IA excelle dans l’enveloppe textuelle mais faillit sur le fond réflexif.

Cette distanciation entre l’auteur et son texte se reflète dans les entretiens post-écriture. À peine la moitié des participants du groupe LLM déclarent se sentir les auteurs véritables de leur essai, contre près de 90 % dans le groupe cerveau seul. Pire encore : une majorité de ces utilisateurs sont incapables de citer une seule phrase de leur propre production quelques minutes après l’avoir écrite. Ce déficit de rémanence mémorielle suggère un faible engagement cognitif dans le processus rédactionnel.

À l’inverse, les groupes ayant écrit sans IA, ou avec des recherches ciblées sur Internet, ont davantage investi leurs textes, y intégrant des références personnelles, des exemples concrets, et des structures argumentatives plus diversifiées. Le sentiment de propriété intellectuelle y est plus fort, la capacité de restitution immédiate bien plus élevée, et la tonalité des textes souvent plus vivante.

En somme, le recours à ChatGPT semble faciliter l’acte d’écrire tout en le vidant partiellement de sa substance réflexive. Une commodité de surface, mais un appauvrissement de la pensée critique et de la mémoire sémantique.

L’effet de renversement – Quand l’IA laisse des traces

La quatrième session expérimentale, conçue comme une inversion des conditions initiales, met en lumière un phénomène remarquable : la manière dont l’usage préalable ou non de l’IA façonne profondément les stratégies cognitives ultérieures.

D’un côté, les participants qui avaient rédigé leurs trois premiers essais avec l’aide de ChatGPT ont montré, une fois privés de cette assistance, une perte manifeste d’agilité mentale. Ils ont éprouvé des difficultés à organiser leurs idées, à développer une argumentation cohérente, voire à écrire avec fluidité. Leurs réponses aux entretiens révèlent une forme de « désorientation rédactionnelle », souvent accompagnée d’un sentiment d’inconfort ou de frustration. Les mesures EEG confirment cette observation : leur activité cérébrale reste faible, comme si leur cerveau était resté conditionné à attendre des suggestions externes. On observe alors un réflexe d’économie cognitive, où les circuits associés à la mémoire de travail et à la planification sont sous-sollicités.

À l’opposé, les participants du groupe initialement sans aide, une fois autorisés à utiliser ChatGPT, n’ont pas abandonné leurs compétences. Au contraire, ils ont su mobiliser l’outil de manière critique et ciblée. Plutôt que de copier ou de suivre passivement les suggestions de l’IA, ils s’en sont servis pour tester des idées, enrichir des exemples ou vérifier certaines formulations. Les entretiens révèlent un usage instrumentalisé de l’IA, au service d’une réflexion déjà en place. L’analyse EEG montre chez eux une augmentation notable de la connectivité neuronale, traduisant une intégration active de l’outil dans leur processus cognitif.

Ce contraste met en évidence un point clé : l’ordre d’exposition à l’intelligence artificielle influence durablement le rapport que l’on entretient avec elle. Lorsqu’un individu développe d’abord ses capacités de raisonnement, de structuration et de rédaction en autonomie, l’introduction ultérieure d’une IA peut agir comme un catalyseur. À l’inverse, une exposition précoce et exclusive à l’outil conduit à une forme de dépendance silencieuse, qui affaiblit les capacités cognitives fondamentales. Il ne s’agit donc pas seulement de savoir si l’IA est utilisée, mais à quel moment et dans quelle posture mentale elle entre dans le parcours d’apprentissage.

Une facilité trompeuse ? Les risques d’un apprentissage passif

L’étude rejoint un ensemble croissant de recherches sur la charge cognitive et les effets induits par l’externalisation de l’effort mental, notamment ce que l’on appelle l’effet Google. Cet effet désigne la tendance à se reposer sur les moteurs de recherche (et désormais sur les IA) pour retrouver de l’information, plutôt que de chercher à la mémoriser. Cette délégation mentale à un outil externe transforme profondément la façon dont les individus interagissent avec le savoir.

Dans le cadre de l’utilisation d’un LLM comme ChatGPT, cette délégation atteint un niveau supérieur : on ne se contente plus de consulter une source, on reçoit directement un discours structuré, une réponse préformée, souvent convaincante, sans avoir à en vérifier la cohérence ni à en explorer la construction. Ce glissement de l’apprentissage actif vers la consommation passive d’un contenu prêt-à-penser constitue une menace sérieuse pour la formation de la pensée critique.

La « paresse métacognitive » évoquée par les auteurs se manifeste par plusieurs indicateurs convergents : une baisse du rappel mémoriel, une moindre capacité à justifier un raisonnement, une propension à accepter les affirmations comme vraies en l’absence de vérification. Autrement dit, l’IA rend l’apprentissage plus confortable, mais aussi plus superficiel.

On observe également une diminution de la capacité à faire des liens entre les savoirs, à contextualiser les informations, ou à reformuler de manière personnelle un argument ou une idée. Ces opérations sont pourtant au cœur de la consolidation des apprentissages et de l’acquisition d’une pensée autonome. Ainsi, ce que l’on gagne en vitesse, en accessibilité, voire en productivité, on le perd souvent en profondeur, en rigueur et en solidité cognitive.

L’enjeu dépasse donc la simple efficacité : il s’agit de ne pas confondre information reçue et connaissance acquise. Le risque est grand que l’utilisation massive et non régulée des LLM n’installe une génération d’apprenants très à l’aise avec l’interface, mais appauvrie dans sa capacité à penser par elle-même.

Pour une pédagogie augmentée, pas déléguée

Face aux résultats de cette étude, une certitude s’impose : l’intelligence artificielle, dans sa forme actuelle, ne peut être intégrée à l’enseignement supérieur sans une réflexion pédagogique approfondie. Interdire son usage serait à la fois irréaliste et appauvrissant. Mais à l’inverse, l’introduire sans accompagnement critique revient à ouvrir la porte à une atrophie silencieuse des capacités cognitives fondamentales.

L’objectif doit donc être clair : outiller les étudiants pour qu’ils apprennent à penser avec l’IA, et non à penser à sa place. Cela suppose un changement de paradigme éducatif, fondé sur trois piliers indissociables :

  • Former à l’usage stratégique des LLM : il ne suffit pas de savoir interagir avec ChatGPT, il faut apprendre à l’interroger de manière réflexive, à détecter les réponses superficielles, à enrichir un contenu généré plutôt qu’à s’y soumettre. Cela suppose des ateliers spécifiques, où l’IA devient un partenaire à évaluer, à tester, à recadrer.
  • Conserver des moments d’écriture sans assistance : l’autonomie intellectuelle ne se décrète pas, elle s’entraîne. Maintenir des temps réguliers d’écriture libre, de prise de notes à la main, ou d’exercices argumentatifs sans technologie permet d’entretenir les muscles mentaux essentiels : mémoire de travail, logique, créativité, style personnel.
  • Faire réfléchir les étudiants sur leur rapport à l’IA : il ne s’agit pas seulement d’apprendre à utiliser un outil, mais de comprendre l’impact de cet outil sur soi. À qui appartiennent les idées générées ? Qu’est-ce qu’une pensée authentique ? Quelle est la frontière entre assistance et triche ? Ces questions méritent d’être intégrées aux cours, discutées, problématisées.

Cette approche vise une pédagogie véritablement augmentée, où la technologie soutient l’intelligence humaine sans s’y substituer. C’est un équilibre fragile, mais indispensable, pour éviter que l’école ne devienne un lieu de consommation cognitive plutôt qu’un lieu de formation de l’esprit critique.

Ce qu’il faut en retenir

Cette étude du MIT apporte un éclairage inédit sur les effets concrets de l’intelligence artificielle générative sur nos capacités cognitives. En révélant les différences d’activation cérébrale, de profondeur argumentative et de mémorisation entre les étudiants selon qu’ils utilisent ou non une IA comme ChatGPT, elle met en lumière un enjeu éducatif majeur : la qualité de notre pensée dépend en grande partie de la manière dont nous sollicitons – ou déléguons – nos efforts mentaux.

L’IA, si elle est mal utilisée, favorise une forme de dépendance intellectuelle, où la fluidité du texte remplace l’effort de compréhension, où la structure remplace le fond. Cette dépendance, en s’installant, altère durablement la mémoire, la pensée critique et le sentiment d’appropriation de ses idées. Elle installe ce que les chercheurs appellent une dette cognitive, c’est-à-dire une perte de réflexes mentaux fondamentaux difficile à résorber.

Pourtant, l’IA n’est pas en soi le problème. Ce sont nos usages, notre posture cognitive, notre éducation à la distance critique qui déterminent si elle devient un adjuvant pédagogique ou un anesthésiant de la pensée. Lorsqu’elle est introduite après l’apprentissage autonome, et non à sa place, elle peut renforcer la réflexion. Lorsqu’elle est encadrée, questionnée, problématisée, elle devient un levier plutôt qu’un substitut.

Réapprendre à penser par soi-même, avant de penser avec la machine, voilà sans doute le défi pédagogique majeur de la décennie. Pour y répondre, il faut repenser la manière d’enseigner, valoriser l’effort intellectuel, redonner sa place à la lenteur réflexive, et faire de chaque interaction avec l’IA un moment conscient de confrontation d’idées, et non de simple délégation.

En définitive, ce que cette étude nous apprend, c’est que l’enjeu éducatif du XXIe siècle ne sera pas seulement de savoir utiliser les machines, mais de préserver et cultiver ce qui, en nous, pense encore sans elles.


#
IA
#LLM
#DetteCognitive
#PédagogieAugmentée

Source : Kosmyna, N. et al. (2024), Your Brain on ChatGPT: Accumulation of Cognitive Debt when Using an AI Assistant for Essay Writing Task, MIT Media Lab. https://arxiv.org/abs/2506.08872

Par |21 juin 2025|Catégories : IA|Mots-clés : , , |0 commentaire
Aller en haut